この記事の要点
- Googleは、生成AI検索に構造化データは必須ではなく、追加すべき特別なschema.orgのマークアップもないと書いています。 そのうえで、リッチリザルトのために使い続けることは勧め、構造化データをページの見える文と一致させるよう求めています。Microsoft は、AI検索の回答のためにスキーマで構造を整えることを勧めていますが、選ばれることを保証するものはないとも書いています。OpenAI・Perplexity・Anthropic の確認した資料には、構造化データの記載はありませんでした。
- Google検索のFAQのリッチリザルトは、2026年5月7日から表示されなくなりました。 Googleは5月8日に告知し、6月15日に説明のページを削除しています。schema.org の FAQPage の型は今もありますが、「FAQの構造化データを入れると検索結果にFAQが出る」という説明は、現在のGoogle検索には当てはまりません。
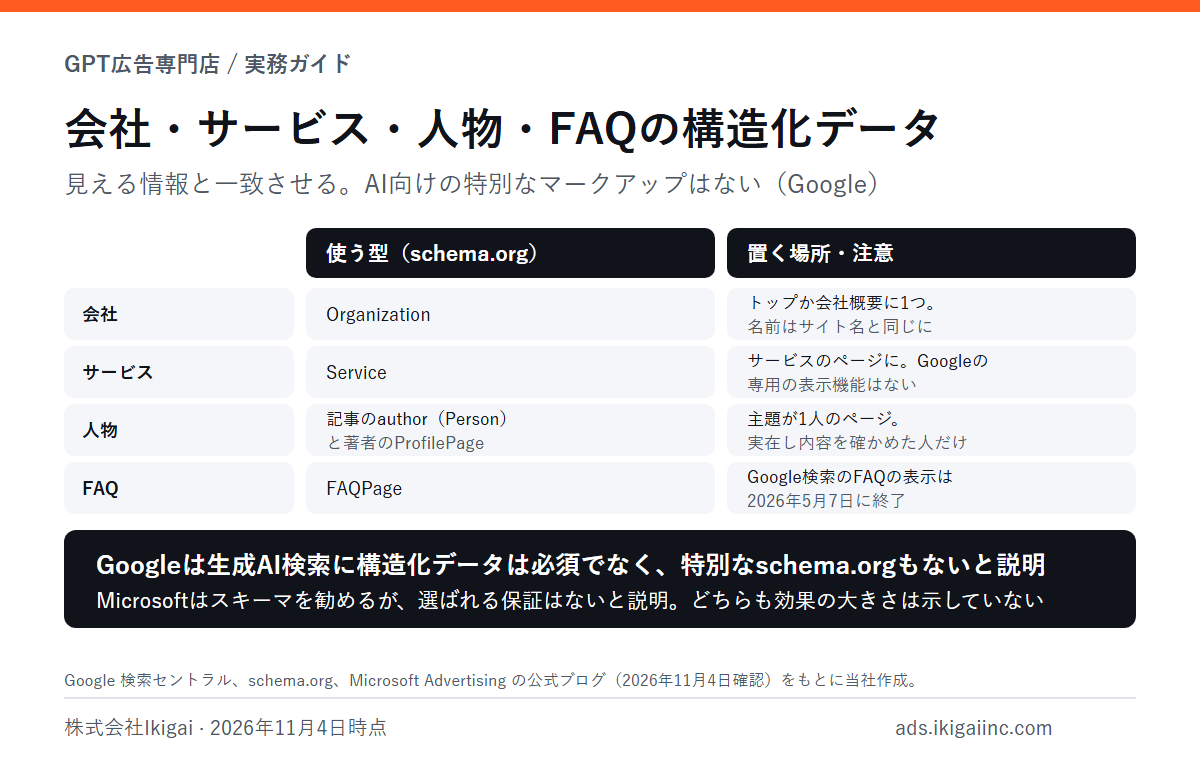
- 会社・サービス・人物の構造化データは、AI向けの特別な作業ではなく、事実を正確にそろえる作業です(当社の見解)。 会社は Organization をトップページか会社概要に、著者は記事の author と著者のページ(ProfilePage)で示し、サイトの見える情報・社外のプロフィールと食い違わないようにします。
読んでほしい人:自社サイトの構造化データを外注先に任せている、またはLLMO対策として構造化データの追加を提案された企業のWeb担当・マーケティング責任者。
この記事で扱わないこと:LLMO対策の全体はLLMO対策とは、Googleの AI 機能の表示の制御はAIO対策で扱います。
構造化データとは:Googleの説明
構造化データは、ページの内容の意味を、検索エンジンが読み取りやすい決まった形式で書き加えたものです。Googleの説明の要点は次のとおりです。
項目 | Googleの説明(要約) |
|---|---|
何のためか | ページの意味の手がかりを Google に明示的に伝える。リッチリザルト(目立つ形の検索結果)の対象になれる |
ほかの使われ方 | ページの内容の理解に加え、マークアップに含まれる人・本・会社などについて、Web と世界の情報を集めるためにも使う |
語彙 | 多くは schema.org の語彙を使う。ただし Google 検索の動きについては Google 検索セントラルの説明を正とする。schema.org には Google 検索が求めない項目もあり、他の検索エンジンやサービスで役立つことがある |
形式 | JSON‑LD(推奨)・Microdata・RDFa。JavaScript で後から差し込んだ JSON‑LD も読める |
表示の保証 | 正しくマークアップしても、検索結果に表示されることは保証しない |
Googleは、必須のプロパティ(項目)がなければリッチリザルトの対象にならないとしつつ、推奨の項目を不完全・不正確にたくさん入れるより、少なくても完全で正確なほうが大切だと書いています。また、sameAs などの schema.org の構造化データを一般的に使うことがあり、将来の機能に使われることもある、と説明しています。
AIの回答に効くのか:各社の公式の書き方
LLMO対策として構造化データが勧められることがありますが、事業者によって公式の書き方が違います。
事業者 | 公式の資料の書き方(要約) |
|---|---|
生成AI検索に構造化データは必須でなく、追加すべき特別なschema.orgのマークアップもない。ただし、リッチリザルトの対象になるため、SEO全体の一部として使い続けるのはよい。SEOの基本の1つに、構造化データをページの見える文と一致させることを挙げる | |
Microsoft | スキーマは、検索エンジンとAIのシステムが内容を理解するのを助ける。商品・レビュー・FAQ・イベントなどとしてラベルを付けられる。チェックリストに「スキーマ、明確な見出し、まとまりのある構成で整える」を挙げる。一方で、AIの回答に選ばれることを保証する方法はないとも書く |
OpenAI・Perplexity・Anthropic | 確認したクローラーと検索の資料に、構造化データについての記載は見当たらない |
どの事業者も、構造化データでAIの回答での引用がどれだけ増えるかの数字は示していません。当社の見解では、構造化データは「AIに引用されるための特別な手段」として扱うより、会社・サービス・人物の事実を、機械が読める形でサイトの見える情報とそろえる作業として扱うのが妥当です。Googleがマークアップに含まれる会社や人の情報を集めるために構造化データを使うと書いている以上、誤った情報を載せないことのほうが先に来ます。
Googleが求める基本のルール
Googleの「構造化データに関する一般的なガイドライン」(英語版の最終更新は2026年7月10日)と構造化データの基本の説明は、すべての構造化データに当てはまるルールを書いています。企業サイトで特に関係するのは次の点です。
- ページの見える内容と同じことをマークアップする。正しい情報でも、利用者に見えない情報はマークアップしない
- 構造化データを置くためだけに、空のページや中身のないページを作らない
- 無関係な内容や、誤解を招く内容(偽のレビューなど)をマークアップしない
- 人や組織になりすましたり、所有・提携・主な目的を偽ったりしない
- 情報を最新に保つ
- 説明する内容があるページに置き、schema.org の中で最も具体的な型を使う
- robots.txt や noindex で、構造化データのあるページを Googlebot から止めない
違反があると、手動による対策を受けることがあります。ガイドラインによると、構造化データの手動による対策では、そのページがリッチリザルトの対象から外れますが、ウェブ検索の順位には影響しません。正しく書いても表示は保証されず、表示するかどうかは検索の状況によって Google が判断します。
AIで構造化データを作る場合も、Googleの生成AIコンテンツのガイダンスは、構造化データを公開前に人が確かめる対象に挙げています(詳しくはAIで書いた記事はSEOで評価される?)。
会社とサービス:Organization・Service
会社:Organization
Googleの Organization の説明によると、トップページに組織の構造化データを入れることは、Google が組織の管理上の情報を理解し、検索結果で他の組織と区別するのに役立つことがあります。一部の項目は裏側で区別に使われ、一部はロゴやナレッジパネルの表示に影響し得ると書かれています。
項目 | Googleの説明(要約) |
|---|---|
必須のプロパティ | ない。当てはまる推奨の項目をできるだけ入れる |
置く場所 | トップページか、会社概要など組織を説明する1ページ。すべてのページに入れる必要はない |
型 | 当てはまる最も具体的な下位の型(ECなら OnlineStore、店舗なら LocalBusiness など) |
name | サイト名と同じ名前・別名を使う |
url | 組織を一意に識別するのに役立つ |
logo | 112×112ピクセル以上、クロール・インデックスできる画像 |
sameAs | SNSやレビューサイトなど、他のサイトにある組織のプロフィールのURL。複数指定できる |
その他 | legalName(登記上の名前)、address、contactPoint、telephone(国番号と市外局番)、email、description、foundingDate など |
短い例です(会社名・URLは架空のものです)。
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "Organization",
  "name": "株式会社サンプル",
  "alternateName": "サンプル",
  "url": "https://www.example.com/",
  "logo": "https://www.example.com/images/logo.png",
  "telephone": "+81-3-0000-0000",
  "address": {
    "@type": "PostalAddress",
    "postalCode": "000-0000",
    "addressRegion": "東京都",
    "addressLocality": "千代田区",
    "streetAddress": "サンプル1-2-3",
    "addressCountry": "JP"
  },
  "sameAs": [
    "https://www.example.org/company/sample"
  ]
}
</script>
当社の提案として、会社名・住所・電話番号・代表者などは、会社概要のページ、Google ビジネス プロフィール、SNSのプロフィールと一字一句そろえます。Googleの AI 機能のページも、Merchant Center とビジネス プロフィールの情報を最新にすることを、SEOの基本の例に挙げています。
サービス:Service
Googleの構造化データの機能の一覧(2026年10月16日更新)には、サービスそのものを対象にした機能はありません。schema.org には Service という型があり、「組織が提供するサービス」と定義され、provider(提供者)、areaServed(提供地域)、serviceType(サービスの種類)、offers(提供の条件)などの項目があります。
Googleは、ここに書かれていない schema.org の構造化データも一般的に使うことがあると説明していますが、Service を使うことで Google 検索の表示がどう変わるかは書いていません。当社の見解では、サービスのページに Service を入れるなら、ページに書いてあるサービス名・提供地域・提供者だけにし、料金や条件はページの記載と一致させます。料金を変えたときに構造化データだけ古いまま残る、という食い違いが起きやすいためです。
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "Service",
  "name": "業務システムの導入支援",
  "serviceType": "システム導入支援",
  "areaServed": "JP",
  "provider": {
    "@type": "Organization",
    "name": "株式会社サンプル",
    "url": "https://www.example.com/"
  }
}
</script>
人物:記事の著者と ProfilePage
人物の構造化データは、記事の著者を示す使い方が中心になります。Googleの Article の説明(必須のプロパティはない)は、著者のマークアップについて次のことを勧めています。
- ページに著者として示すすべての人を、マークアップにも入れる
- 複数の著者は、1人ずつ別の author に入れる(1つの name にまとめない)
- type と url(または sameAs)を入れることを強く勧める。人なら、著者のことが分かるページへリンクする
- author.name には名前だけを入れる。媒体名は publisher、肩書は jobTitle に分ける
- 人は Person、組織は Organization の型を使う
著者のページには ProfilePage を使えます。Googleの説明では、必須の項目は mainEntity(ページの主題の人か組織)で、ページの主題はサイトに関係する1人の人か1つの組織でなければなりません。有効な例として、ニュースサイトの著者のページ、会社のサイトの社員のページが挙げられています。店舗のトップページは無効な例です。
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "BlogPosting",
  "headline": "記事の題名",
  "datePublished": "2026-11-04T09:00:00+09:00",
  "author": [{
    "@type": "Person",
    "name": "山田 花子",
    "jobTitle": "編集担当",
    "url": "https://www.example.com/staff/yamada"
  }],
  "publisher": {
    "@type": "Organization",
    "name": "株式会社サンプル"
  }
}
</script>
著者のページ(上の url の先)には、次のように ProfilePage を置きます。
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "ProfilePage",
  "mainEntity": {
    "@type": "Person",
    "name": "山田 花子",
    "jobTitle": "編集担当",
    "worksFor": {
      "@type": "Organization",
      "name": "株式会社サンプル"
    }
  }
}
</script>
Googleは、AIで作った顔写真・架空の名前・偽りの資格で、人の専門家が書いたように見せることを欺瞞としています。著者の構造化データは、実在し、実際に内容を確かめた人だけにします。
FAQ:Google検索での表示は終わった
FAQの構造化データについて、Google 検索セントラルの変更履歴には次のように記録されています。
日付 | 変更履歴の記載(要約) |
|---|---|
2023年9月14日 | FAQのリッチリザルトは、よく知られた権威のある政府・健康のサイトだけに表示すると説明を更新 |
2026年5月8日 | FAQのリッチリザルトの説明に廃止の告知を追加。2026年5月7日から Google 検索に表示されなくなる |
2026年6月15日 | FAQのリッチリザルトは Google 検索の結果に表示されなくなったため、説明のページを削除 |
Googleの構造化データの機能の一覧にも、2026年11月4日時点でFAQはありません。schema.org の FAQPage は「1つ以上のよくある質問を示すWebページ」と定義された型として今もあり、Microsoft は、スキーマで付けられるラベルの例にFAQを挙げています。
当社の見解では、すでに FAQPage を入れているページについて、外すよう求める記載は確認した公式の資料にはありません。一方で、Google検索での表示を期待して新しく入れる理由もありません。FAQの節そのものは、読み手の疑問に答える形として価値があります。入れておく場合は、見える質問と答えと一字一句同じにし、答えを変えたら構造化データも同時に直します。
<script type="application/ld+json">
{
  "@context": "https://schema.org",
  "@type": "FAQPage",
  "mainEntity": [{
    "@type": "Question",
    "name": "初期費用はかかりますか。",
    "acceptedAnswer": {
      "@type": "Answer",
      "text": "初期費用はかかりません。"
    }
  }]
}
</script>
実装と確認の手順(当社の提案)
構造化データは、テーマ・プラグイン・タグマネージャー・CMSの設定など、複数の場所から入っていることがあります。外注先が入れたものが残っていることもあるため、次の順で確かめます。
- 今入っている構造化データを洗い出す。 主要なページで、どの型が、どこから(テーマ、プラグイン、タグマネージャー)入っているかを一覧にします。同じ組織の情報が2か所から入って食い違っていないかも見ます。
- 見える情報と照らし合わせる。 会社名・住所・電話番号・料金・著者・FAQの答えが、ページの文と一致しているかを確かめます。
- 検証する。 リッチリザルト テストで構文の誤りを確かめ、URL検査ツールで Google が受け取るページを確かめます。公開後は、Search Console のリッチリザルトのステータス レポートで、テンプレートの変更などで壊れていないかを見ます。
- 情報を変えたら同時に直す。 料金・所在地・担当者・FAQの答えを変えたときに、構造化データも直すことを、更新の手順に入れます。
外注先を乗り換えるときは、構造化データをどこで実装しているかの一覧を受け取ります(SEO会社の乗り換え方)。
この記事で分からないこと
- 構造化データで、AIの回答での引用がどれだけ増えるか。 Google・Microsoft とも効果の大きさを示していません。
- ChatGPT・Perplexity・Claude が構造化データを読むか。 確認した各社のクローラーと検索の資料には記載がありませんでした。
- Service など、Google の機能の一覧にない型の使われ方。 Googleは一般的に使うことがあるとだけ書いています。
- Q&A(QAPage)の構造化データが、会社のFAQに使えるか。 Googleの機能の一覧にはありますが、本記事では説明のページを確認していません。
- FAQPage を入れたままにすることの影響。 表示が終わったことは書かれていますが、残したマークアップの扱いは変更履歴に書かれていません。
構造化データの点検チェックリスト
- [ ] 会社の Organization が、トップページか会社概要に1つある
- [ ] Organization の name がサイト名と同じで、会社概要・ビジネス プロフィール・SNSの情報と一致している
- [ ] 料金・提供地域などを構造化データに入れる場合、ページの記載と一致している
- [ ] 記事の author に、ページに示す全員が1人ずつ入り、著者のページへの url がある
- [ ] 著者・社員のページは、主題が1人に絞られている
- [ ] 著者は実在し、架空の名前や作った顔写真を使っていない
- [ ] FAQPage を入れている場合、見える質問と答えと同じで、Google検索での表示を前提にしていない
- [ ] リッチリザルト テストと URL 検査ツールで確かめ、Search Console のステータス レポートを見ている
- [ ] 構造化データがどこから入っているか(テーマ・プラグイン・タグマネージャー)を一覧にしている
よくある質問
Q. LLMO対策として、構造化データを全ページに入れるべきですか。 Googleは、生成AI検索に構造化データは必須でなく、特別なマークアップもないと書いています。Organization も、すべてのページに入れる必要はなく、トップページか会社概要に置くよう勧めています。全ページに入れることより、ページの内容に合う型を、見える情報と一致させて入れることを優先してください。
Q. FAQの構造化データは削除したほうがよいですか。 Googleの資料には、FAQPage を残すと不利になるという記載はありません。Google検索での表示は2026年5月7日から終わっているため、表示を目的に残す意味はなくなっています。残す場合は、見える質問と答えと一致させ、答えを変えたときに同時に直す手間がかかる点を考えて判断してください(当社の見解)。
Q. 構造化データを入れたのに、リッチリザルトが表示されません。 Googleは、正しくマークアップしても表示は保証しないと明記しています。表示されない理由として、ページの主な内容を表していない、誤解を招く、テストで見つからない誤りがある、内容が利用者から隠れている、ガイドラインに反している、などを挙げています。まずリッチリザルト テストと URL 検査ツールで確かめてください。
Q. 構造化データの手動による対策を受けると、順位は下がりますか。 Googleの一般的なガイドラインによると、構造化データの手動による対策では、そのページがリッチリザルトの対象から外れますが、ウェブ検索の順位には影響しません。ただし、構造化データとは別に、スパムに関するポリシーに違反している場合は別の扱いになります。Search Console の手動による対策のレポートで確かめられます。
Q. 社外のプロフィールを sameAs にどこまで入れればよいですか。 Googleは、sameAs に、SNSやレビューサイトなど他のサイトにある組織のプロフィールのURLを入れられ、複数指定できると説明しています。入れる数の目安は示していません。自社が管理し、内容が最新のプロフィールだけを入れることを勧めます(当社の見解)。更新していないアカウントを入れると、読み手や検索エンジンが古い情報にたどり着くことがあるためです。
まとめ
- Googleは、生成AI検索に構造化データは必須でなく、特別なschema.orgもないと書く。リッチリザルトのために使い続けるのはよく、見える文と一致させることを求める
- Microsoft はスキーマを勧めるが、選ばれる保証はないと書く。OpenAI・Perplexity・Anthropic の確認した資料には記載がない
- Google検索のFAQのリッチリザルトは2026年5月7日から表示されない。FAQPage の型は schema.org に残っている
- 会社は Organization をトップか会社概要に、人物は記事の author と著者のページ(ProfilePage)で。サービスの Service に Google の専用の機能はない
- 構造化データは、事実をそろえる作業。どこから入っているかを洗い出し、見える情報と照らし合わせ、情報を変えたら同時に直す
いまのSEO・LLMOの外注費と作業範囲を見直したい場合は、GPT広告専門店のSEO・LLMO運用をご覧ください。月額30万円以上で外注中の企業を対象に、現契約の見積書をもとに同じ本数・同じ範囲を半額で引き受けています(条件と例外はページに記載しています)。
出典
- Introduction to structured data markup in Google Search(Google 検索セントラル。英語版の最終更新2025年12月10日、日本語版2025年12月18日。構造化データの目的、使われ方、語彙、形式)
- General structured data guidelines(「構造化データに関する一般的なガイドライン」。英語版2026年7月10日、日本語版2026年9月16日。表示の保証がないこと、品質のルール、手動による対策)
- Organization structured data(2026年9月8日。置く場所、推奨の項目)
- Article structured data(2026年9月8日。著者のマークアップ)
- Profile page structured data(2026年9月8日。mainEntity、有効な例)
- Structured data markup that Google Search supports(2026年10月16日。機能の一覧)
- Latest documentation updates(Google 検索セントラルの変更履歴。2023年9月14日、2026年5月8日、2026年6月15日のFAQの項目)
- Optimizing your website for generative AI features on Google Search(生成AI検索に構造化データは必須でなく、特別なマークアップもないこと。リッチリザルトのために使い続けるのはよいこと)
- AI features and your website(構造化データを見える文と一致させること)
- Google Search's guidance on using generative AI content on your website(AIで作った構造化データの確認)
- schema.org FAQPage・Question・Service・Person・Organization(型と項目の定義)
- Optimizing Your Content for Inclusion in AI Search Answers(Microsoft Advertising の公式ブログ、2025年10月8日。スキーマの勧め)
- Overview of OpenAI Crawlers・Perplexity Crawlers・Does Anthropic crawl data from the web, and how can site owners block the crawler?(構造化データの記載がないことの確認)
いずれも2026年11月4日に本文を確認しています。
変更履歴
日付 | 内容 |
|---|---|
2026年11月4日 | 初版。Google 検索セントラル10本(うち2本は英語版・日本語版)、schema.org 5本、Microsoft Advertising の公式ブログ1本、OpenAI・Perplexity・Anthropic のクローラーの資料の本文を確認 |
次回確認予定:2026年12月上旬。 Google の構造化データの機能の一覧と変更履歴、生成AI検索の最適化のガイドの構造化データの記述を確認します。