この記事の要点
- AIのクローラーは、目的で3種類に分かれます。 AIの学習用(GPTBot・ClaudeBot など)、検索や回答のための巡回用(OAI-SearchBot・Claude-SearchBot・PerplexityBot など)、利用者の操作に応じた取得(ChatGPT-User・Perplexity-User など)です。多くの事業者が、これらを別々の名前で管理できるようにしています。
- 「学習には使われたくないが、回答には出たい」は、多くの事業者で設定を分けられます。 ただし、名前の使い方は事業者ごとに違います。Googleの Google-Extended は Google 検索の掲載や順位に影響しないと明記されており、止めても AI による概要からは外れません。
- robots.txt だけでは足りません。 WAF・CDN・ボット対策が検索用のクローラーを止めていることがあり、利用者の操作による取得には robots.txt が当てはまらないこともあります。設定は、各社の公開するIPアドレスの一覧と組み合わせて確かめます。
読んでほしい人:AIの学習への利用を止めるべきか、AIの検索・回答には出したいかを、社内で決める必要があるWeb担当・情報システム担当・マーケティング責任者。
この記事で扱わないこと:ChatGPT広告の審査に必要な OAI-AdsBot の設定は、目的が違うためChatGPT広告のクローラー許可の記事で扱います。
AIクローラーは「何のために来るか」で3種類に分かれる
クローラーは、Webのページを自動で取りに来るプログラムです。AIの事業者は、目的ごとに名前(ユーザーエージェント)を分けています。
種類 | 何のためか | 止めたときの影響(各社の説明の要約) | 例 |
|---|---|---|---|
学習用 | AIのモデルの学習に使い得る内容を集める | 学習に使わないでほしいという意思表示になる | GPTBot、ClaudeBot |
検索・回答用 | AIの検索や回答で、サイトを表示・リンクするための巡回 | 検索の回答に出ない、または出にくくなる | OAI-SearchBot、Claude-SearchBot、PerplexityBot |
利用者の操作による取得 | 利用者の質問に応じて、その場でページを開く | 事業者によって robots.txt が当てはまらないことがある | ChatGPT-User、Perplexity-User、Claude-User |
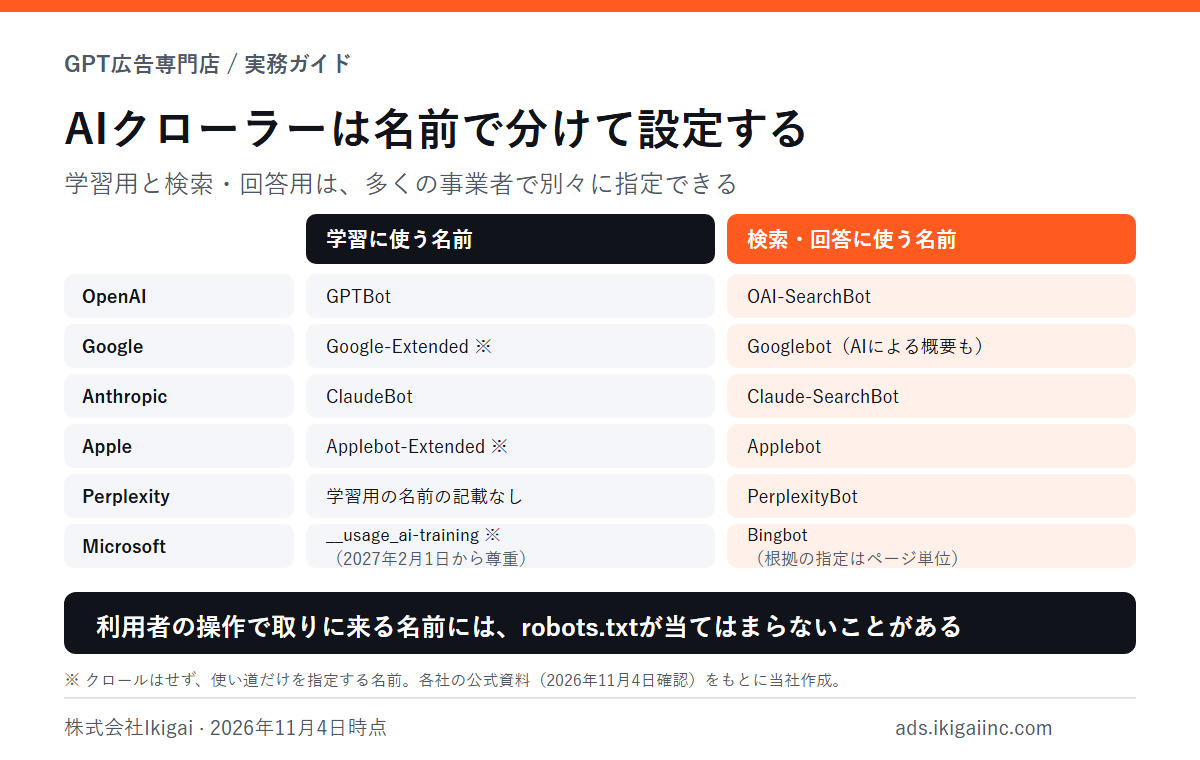
これとは別に、クロールをせず、集めた内容の使い道だけを指定する名前もあります。Googleの Google-Extended と、Apple の Applebot-Extended です。どちらも、既存のクローラー(Google の既存のクローラー、Applebot)が集めた内容を、学習などに使ってよいかを指定するための名前です。
主なクローラーの一覧(2026年11月4日時点)
各社の公式資料に載っている名前と用途です。名前は robots.txt の User-agent に書く文字列です。
事業者 | 名前 | 用途(公式の説明) | 止めたとき(公式の説明) |
|---|---|---|---|
OpenAI | GPTBot | 生成AIの基盤モデルの学習に使い得る内容を集める | 学習に使うべきでないという意思表示 |
OpenAI | OAI-SearchBot | ChatGPT の検索機能でサイトを表示する | 検索の回答に出ない。案内のリンクとしては出得る |
OpenAI | ChatGPT-User | 利用者の操作に応じてページを開く。自動の巡回には使わない | 利用者の操作のため robots.txt が当てはまらないことがある |
Googlebot | Google 検索(AIによる概要・AIモードを含む)のクロール | 検索に出にくくなる | |
Google-Extended | Gemini の学習と、Gemini アプリなどでのグラウンディング(回答の根拠に使うこと)の管理。クロールは既存の Google のクローラーが行う | Google 検索の掲載や順位には影響しない | |
Anthropic | ClaudeBot | 学習に使い得る内容を集める | 今後の内容を学習用データから外す意思表示 |
Anthropic | Claude-SearchBot | 検索の回答の関連性と正確さを高める | 検索の結果での見え方と正確さが下がり得る |
Anthropic | Claude-User | 利用者の質問に応じてページを取りに行く | 利用者の検索での見え方が下がり得る |
Perplexity | PerplexityBot | Perplexity の検索結果でサイトを表示・リンクする。基盤モデルの学習には使わない | 検索結果に出るために許可を推奨 |
Perplexity | Perplexity-User | 利用者の操作に応じてページを開く。学習には使わない | 利用者の要求のため、robots.txt を概ね無視する |
Apple | Applebot | Spotlight・Siri・Safari の検索。Apple の基盤モデルの学習や、AIの回答の文脈にも使われ得る | 許可すると Apple の製品の検索結果に出られると説明 |
Apple | Applebot-Extended | Applebot が集めた内容を学習に使うかの指定。クロールはしない | 学習から外れる。検索の掲載・順位には影響しない |
Common Crawl | CCBot | 誰でも利用・分析できる、Webのクロールデータの公開の保存庫を作る | Common Crawl に集められない |
Microsoft は、クローラーで集めたWebの内容を、学習や、Bing・Copilot・Microsoft 365 の回答の根拠に使うと説明しています。2026年10月30日の Bing の公式ブログによると、学習(AI Training)と回答の根拠(AI Grounding)を別々に指定する新しい方法を、2027年2月1日からクロールの際に尊重します。学習はサイト・パス単位なら robots.txt の共通の名前(__usage_ai-training)、ページ単位なら Bingbot 向けの meta タグか X-Robots-Tag で、回答の根拠はページ単位だけで指定します。これまでの NoArchive・NoCache の指定は置き換えられ、2027年3月1日以降は学習・回答の根拠の指定として読まれなくなります。
なお、OpenAI には広告の審査のための OAI-AdsBot もあります。これは ChatGPT 広告として提出されたページだけを訪れ、集めたデータは学習に使わないと説明されているクローラーで、AIの検索や学習の方針とは別に決めます(ChatGPT広告のクローラー許可の記事)。
Google-Extended と Googlebot の関係
名前から AI による概要の設定と取り違えやすいのが、Google-Extended です。Googleのクローラーの資料は、次のように書いています。
- Google-Extended には、独自のユーザーエージェントの文字列がない。クロールは既存の Google のクローラーで行い、robots.txt の名前は「指定のため」に使う
- 対象は、Gemini アプリと Vertex AI の Gemini API を支える将来の Gemini モデルの学習と、Gemini アプリ・Vertex AI の「Grounding with Google Search」でのグラウンディング
- Google-Extended は、Google 検索でのサイトの掲載に影響せず、Google 検索の順位の要因としても使われない
つまり、Google-Extended を止めても、Google 検索の AI による概要・AI モードからは外れません。Google の「AI 機能とウェブサイト」のページも、AI は検索に組み込まれているため、検索のクロールの管理は Googlebot 向けの robots.txt で行うと書いています。AI による概要などに出したくない場合は、Search Console の「検索の生成 AI 設定」や nosnippet を使います(AIO対策の記事)。逆に、Search Console の生成AIの設定で除外しても、AIの学習には影響しないとヘルプは書いています。学習を止めたいなら Google-Extended、AI による概要に出したくないなら生成AIの設定、と分けて考えます。
Googleは、2027年初頭に、業界で共通の学習の指定(AIPREF。robots.txt に「user-agent: __usage_ai-training」と書く形)に対応する予定だとも書いています。Microsoft も、同じ __usage_ai-training の指定を2027年2月1日からクロールの際に尊重するとしています。これはインターネットの標準を決める IETF の作業部会の草案(Internet-Draft)に基づくもので、最終的な標準に向けた作業は続いていると Microsoft は書いています。OpenAI も2026年10月30日に、robots.txt で基盤モデルの学習への使用について意向を示す共通の指定に従うと発表しました。実装は「今後数か月のうち」とされ、詳細は実装の際に改めて知らせるとしています。この指定は、GPTBot など既存の robots.txt での設定を置き換えるものではなく、既存の設定も引き続き適用されると書いています。
「学習は止めたいが、検索・回答には出たい」場合
各社の資料の範囲で、学習と検索・回答を分けられるかを整理しました。
事業者 | 学習を止める | 検索・回答には出す | 補足 |
|---|---|---|---|
OpenAI | GPTBot を不許可 | OAI-SearchBot を許可 | 設定は互いに独立。両方許可していると、1回のクロールの結果を両方に使うことがある |
Google-Extended を不許可 | Googlebot を許可(AIによる概要・AIモードを含む) | Google-Extended の不許可は、Gemini アプリなどでのグラウンディングにも及ぶ | |
Anthropic | ClaudeBot を不許可 | Claude-SearchBot・Claude-User を許可 | 3つとも robots.txt を尊重すると説明 |
Apple | Applebot-Extended を不許可 | Applebot を許可 | Applebot が集めた内容を AI の回答の文脈に使わせたくない場合は、nosnippet |
Perplexity | (学習用の名前は資料にない) | PerplexityBot を許可 | PerplexityBot・Perplexity-User とも学習には使わないと説明 |
Microsoft | robots.txt の | Bingbot を許可し、AI Grounding は既定の「許可」のまま | 指定は内容の使い方の管理で、クロールの許可とは別 |
当社の見解では、企業のサイトで最初に決めたいのは「学習を止めるか」ではなく、「AIの検索・回答に出たいか」です。検索・回答用のクローラーを止めると、OpenAIは検索の回答に出ないと、Anthropic は検索の結果での見え方が下がり得ると書いています。学習を止める方針の会社でも、検索・回答用の名前は分けて許可するのが、各社の資料から素直に読める組み合わせです。
Common Crawl については、ページの説明は「誰でも利用・分析できる公開の保存庫」までで、データを誰が何に使うかは書かれていません。止めるかどうかは、自社の方針で判断します。
robots.txt の書き方の例
学習用は止め、検索・回答用は許可する例です。各社の資料にある書き方をもとに、当社がまとめました。自社のサイトにそのまま使う前に、各社の最新の資料で名前を確かめてください。
# 学習用・学習の指定(止める)
User-agent: GPTBot
Disallow: /

User-agent: ClaudeBot
Disallow: /

User-agent: Google-Extended
Disallow: /

User-agent: Applebot-Extended
Disallow: /

# Common Crawl(公開の保存庫。止めるかは自社の方針で)
User-agent: CCBot
Disallow: /

# 検索・回答用(許可する)
User-agent: OAI-SearchBot
Allow: /

User-agent: Claude-SearchBot
Allow: /

User-agent: PerplexityBot
Allow: /

# それ以外のクローラー
User-agent: *
Allow: /
書くときに見落としやすい点です(いずれも robots.txt の標準 RFC 9309 と各社の資料による)。
- 標準では、クローラーは自分の名前に一致するグループだけに従い、一致がないときだけ「User-agent: *」に従います。 「*」で全体を止めているサイトでは、検索用のクローラーの名前で「Allow」のグループを作らない限り、そのクローラーも止まります
- robots.txt はホスト(サブドメイン)ごとに置きます。 Anthropic も、止めたいサブドメインごとに書くよう求めています
- 一部だけ止めることもできます。 許可と不許可が重なるときは、パスに最も長く一致する規則が使われます。Google-Extended の資料にも、/archive/ を止めつつ一部だけ許可する例があります
- Apple は、Applebot の名前が無く Googlebot の名前がある場合、Googlebot 向けの規則に従います。 Googlebot だけを止めると、Apple の検索にも影響し得ます
- Crawl-delay(取りに来る間隔の指定)は、対応が分かれます。 Anthropic は対応、Apple は従わないと書いています
共通の学習の指定(User-agent: __usage_ai-training)は、Microsoft が2027年2月1日からクロールの際に尊重し、Google は2027年初頭に対応する予定です。OpenAI も2026年10月30日に、共通の指定に従うと発表しましたが、実装の時期と方法の詳細はまだ示されていません。本記事で確認したほかの事業者(Anthropic・Perplexity・Apple・Common Crawl)の資料には、この指定への対応の記載はありません。当面は、上の例のように各社の名前ごとの指定が必要です。
robots.txt で止められないもの・効かないもの
robots.txt は、クローラーに「来ないでほしい」と伝える仕組みで、アクセスを防ぐ仕組みではありません。Googleも、robots.txt はクローラーの振る舞いを強制できず、守るかはクローラー次第だと書いています。
場面 | 各社の説明 | どうするか(当社の見解) |
|---|---|---|
利用者の操作による取得 | OpenAI:ChatGPT-User には robots.txt が当てはまらないことがある。Perplexity:Perplexity-User は概ね無視する。Anthropic:Claude-User も robots.txt を尊重する | 会員限定などの情報は、robots.txt ではなくログインで守る |
検索結果から完全に外したい | Google:robots.txt で止めても、ほかのサイトからリンクされていれば URL が索引に入り得る。外すなら noindex かパスワード | 検索から外す目的なら noindex を使い、クロールは許可する |
AIの回答での使われ方を絞りたい | Google:nosnippet・max-snippet・data-nosnippet。Apple:nosnippet で広い知識の回答に使わない | ページ単位の指定を使う |
IPアドレスで止める | Anthropic:IP の遮断は robots.txt を読めなくするため、正しく効かない、または指定として続かないことがある | 方針の表明は robots.txt で行う |
名前を偽ったアクセス | Google・Common Crawl:ユーザーエージェントは偽装され得る | IP の一覧や逆引き DNS で本物か確かめる |
WAF・CDNのボット対策で止めてしまう問題
robots.txt で許可していても、WAF(Webアプリケーションのファイアウォール)やCDNのボット対策が、検索用のクローラーを止めていることがあります。Googleは、AI による概要・AI モードに向けたSEOの基本として、robots.txt と、CDN・ホスティングの両方でクロールを許可することを挙げています。OpenAIも、ホストやCDNが OpenAI の公開する IP アドレスからのアクセスを通しているかを確かめるよう書いています。
Perplexity の資料には、具体的な設定の手順があります。Cloudflare では、ユーザーエージェントと各ボットのIP範囲を組み合わせたルールで、ほかの防御のルールをスキップさせ、そのルールをブロックするルールより上に置きます。ただし、Cloudflare の Bot Fight Mode はこのルールではスキップできないとも書いています。AWS WAF では、IP の一覧とユーザーエージェントの一致を組み合わせた許可のルールを、ブロックのルールより先に評価させます。
各社が公開する確認の手段は次のとおりです。
事業者 | 本物か確かめる手段(公式の資料) |
|---|---|
OpenAI | searchbot.json・gptbot.json・chatgpt-user.json(IPの一覧) |
common-crawlers.json(IPの一覧)、逆引き DNS | |
Anthropic | bots.json(IPの一覧) |
Perplexity | perplexitybot.json・perplexity-user.json(IPの一覧) |
Apple | 逆引き DNS(applebot.apple.com)、applebot.json |
Common Crawl | 逆引き DNS、ccbot.json |
当社の見解では、ユーザーエージェントだけで例外を作るのは避け、IPの一覧か逆引き DNS と組み合わせます。Perplexity も、ユーザーエージェントとIPの両方で確かめることを勧め、IPの一覧は定期的に更新されるため、自動で取り込む仕組みを作るよう書いています。
変更が反映されるまでの時間
対象 | 目安(公式の説明) |
|---|---|
ChatGPT の検索結果 | robots.txt の更新から約24時間 |
Perplexity | 変更の反映に最大24時間 |
robots.txt の標準 | 取得した robots.txt は原則24時間を超えて使い回さない(RFC 9309) |
Microsoft の AI の指定 | ページが再びクロールされて初めて反映される |
この記事で分からないこと
- 学習を止める前に集められた内容の扱い。 各社の資料は、今後のクロールへの指定として説明しています。
- Common Crawl のデータを、どの事業者が何に使っているか。 Common Crawl のページには書かれていません。
- Bing のヘルプに書かれた細かい設定。 Bing のヘルプのページは、本記事の取得の方法では本文を確認できなかったため、公式ブログの範囲で書いています。
- 本記事で扱っていない事業者のクローラー。 本記事は、OpenAI・Google・Anthropic・Perplexity・Apple・Common Crawl・Microsoft の公式資料の範囲です。
- AIの検索・回答用のクローラーを許可したときに、引用がどれだけ増えるか。 許可は条件であって、表示は各社とも保証していません。
Web担当・セキュリティ担当に渡すチェックリスト
- [ ] 社内で「AIの検索・回答に出たいか」と「学習への利用を止めたいか」を分けて決めた
- [ ] robots.txt で、OAI-SearchBot・Claude-SearchBot・PerplexityBot・Googlebot・Applebot を意図せず止めていない(「User-agent: *」の不許可も確認)
- [ ] 学習を止める場合、GPTBot・ClaudeBot・Google-Extended・Applebot-Extended などを名前で指定した
- [ ] Google-Extended を止めても AI による概要からは外れないこと、外したいなら Search Console の設定を使うことを共有した
- [ ] すべてのサブドメインに robots.txt がある(または意図して置いていない)
- [ ] WAF・CDN・ボット対策で、検索用のクローラーの公開IPを止めていない。許可のルールはIPの一覧と組み合わせている
- [ ] 会員限定・社外秘の情報は、robots.txt ではなくログインで守っている
- [ ] NoArchive・NoCache を使っている場合、2027年3月1日までの Microsoft の移行の手順を確認した
よくある質問
Q. robots.txt に何も書いていない場合、AIのクローラーはどう扱われますか。 robots.txt の標準(RFC 9309)では、当てはまるグループも規則もなければ、どの規則も適用されず、アクセスは許可されたものとして扱われます。Microsoft も、学習と回答の根拠の指定はどちらも、指定がなければ「許可」が既定だと書いています。何も書かないことは、学習・検索の両方を許可しているのと同じ状態だと当社は考えます。
Q. GPTBot を止めると、ChatGPT で自社が紹介されなくなりますか。 OpenAI の資料では、ChatGPT の検索の回答に出るかどうかは OAI-SearchBot の設定で管理し、GPTBot の設定とは独立しています。GPTBot だけを止め、OAI-SearchBot を許可していれば、検索の回答の対象からは外れません。ただし、表示は保証されません。
Q. CMS(WordPress や Wix など)で robots.txt を直接編集できません。 Googleの robots.txt の資料も、CMS によっては robots.txt を直接編集できず、検索の設定の画面など別の方法が用意されていることがあると書いています。使っている CMS の説明で、robots.txt の追記の方法を確かめてください。
Q. AIのクローラーのアクセスが多く、サーバーが重くなります。 Anthropic は非標準の Crawl-delay に対応しています。Apple は Crawl-delay に従わない一方、サイトが遅くなったりエラーを返したりすると自動で巡回の速度を落とすと書いています。止める前に、どのクローラーのアクセスが多いかをサーバーのログで確かめ、名前とIPで本物かを見分けます。
Q. 一度止めたクローラーを、あとから許可し直せますか。 robots.txt を書き換えれば許可し直せます。反映には時間がかかり、ChatGPT の検索結果は約24時間、Perplexity は最大24時間が目安とされています。検索の回答に再び出るかどうかは、各社とも保証していません。
まとめ
- AIのクローラーは、学習用・検索や回答用・利用者の操作による取得の3種類。名前ごとに分けて考える
- 学習は止めて回答には出す組み合わせは、OpenAI(GPTBot/OAI-SearchBot)、Anthropic(ClaudeBot/Claude-SearchBot)、Apple(Applebot-Extended/Applebot)などで分けられる
- Google-Extended は Google 検索の掲載・順位に影響しない。AI による概要に出したくないなら Search Console の設定か nosnippet
- 「User-agent: *」の不許可、サブドメインごとの robots.txt、Apple が Googlebot の規則に従う点に注意する
- WAF・CDN のボット対策で検索用のクローラーを止めていないかを、IPの一覧と組み合わせて確かめる。Microsoft は2027年2月1日から新しい指定に移る
いまのSEO・LLMOの外注費と作業範囲を見直したい場合は、GPT広告専門店のSEO・LLMO運用をご覧ください。月額30万円以上で外注中の企業を対象に、現契約の見積書をもとに同じ本数・同じ範囲を半額で引き受けています(条件と例外はページに記載しています)。
出典
- Overview of OpenAI Crawlers(GPTBot・OAI-SearchBot・ChatGPT-User・OAI-AdsBot の用途、設定の独立、公開IP、約24時間)
- Making it easier for websites to express AI training preferences(2026年10月30日。共通の学習の指定に従う方針、実装は今後数か月、既存の設定は引き続き適用)
- Searching the web with ChatGPT(検索結果の対象になる条件、CDNでのIPの許可)
- List of Google's common crawlers(Googlebot、Google-Extended の対象と Google 検索への影響、AIPREF への対応の予定。英語版2026年10月30日・日本語版2026年11月3日更新)
- Introduction to robots.txt(robots.txt の目的と限界)
- AI features and your website(CDN・ホスティングでのクロールの許可、AI機能の制御)
- Search generative AI control(生成AIの設定は学習に影響しないこと)
- Does Anthropic crawl data from the web, and how can site owners block the crawler?(ClaudeBot・Claude-User・Claude-SearchBot、Crawl-delay、サブドメイン、IPでの遮断)
- Perplexity Crawlers(PerplexityBot・Perplexity-User、反映の時間、Cloudflare・AWS WAF の設定、IPの一覧)
- About Applebot(Applebot・Applebot-Extended、nosnippet、Googlebot の規則に従う場合、Crawl-delay)
- CCBot(Common Crawl、robots.txt の例、偽装への注意、逆引き DNS)
- Your content, your choice: clearer preferences for training and grounding(Bing の公式ブログ、2026年10月30日。AI Training・AI Grounding、2027年からの日程)
- RFC 9309: Robots Exclusion Protocol(グループの選び方、ホストごとのファイル、最も長く一致する規則、キャッシュ)
いずれも2026年11月4日に本文を確認しています。
変更履歴
日付 | 内容 |
|---|---|
2026年11月4日 | 初版。OpenAI 3本(共通の学習の指定についての2026年10月30日の発表を含む)、Google 4本(クローラーの資料は英語版・日本語版)、Anthropic・Perplexity・Apple・Common Crawl 各1本、Microsoft の公式ブログ1本、RFC 9309 の本文を確認 |
次回確認予定:2026年12月上旬。 各社のクローラーの名前と用途の変更、Microsoft の新しい指定(2026年12月15日の一時的な設定の開始)、Google の AIPREF への対応の進み具合を確認します。